英偉達首席執行官黃仁勳在柏林GTC大會上密集發佈新品,覆蓋AI基礎設施、智能體安全、機器人與自動駕駛等多個領域,並向歐洲政商界發出強烈呼籲——所有行業都必須成爲AI公司。
10月21日,英偉達首席執行官黃仁勳在GTC大會上表示,未來所有電信運營商都將提供AI算力,電信基站有望演變爲分佈式AI網絡。他將AI經濟描述爲由能源、算力、AI工廠、模型與應用構成的五層結構,並在展示中突出指出,算力層僅出現英偉達一家公司的標誌。
此次發佈涵蓋模塊化AI數據中心產品DSX Pod、智能體安全架構OpenShell、人形機器人蔘考平台,以及涉及自動駕駛、癌症治療和蛋白質設計等多個垂直領域的新品與合作。英偉達在活動中還宣佈,過去一年已在歐洲投資近100億美元,建立超過12000項合作關係。演講期間一度被綠色和平組織抗議人士打斷,黃仁勳稱將事後與其溝通,隨即繼續演講。
 在當前部分投資者對AI基礎設施投入規模日益質疑的背景下,黃仁勳發出明確看多信號。"歐洲要想從AI中受益,並真正建立起AI生態和AI經濟,就需要所有終端市場、終端行業都採用AI,"他在演講中表示,並點名汽車、金融服務和醫療保健行業。英偉達美股盤前一度漲逾2%。
DSX POD:將部署週期從六個月壓至14天
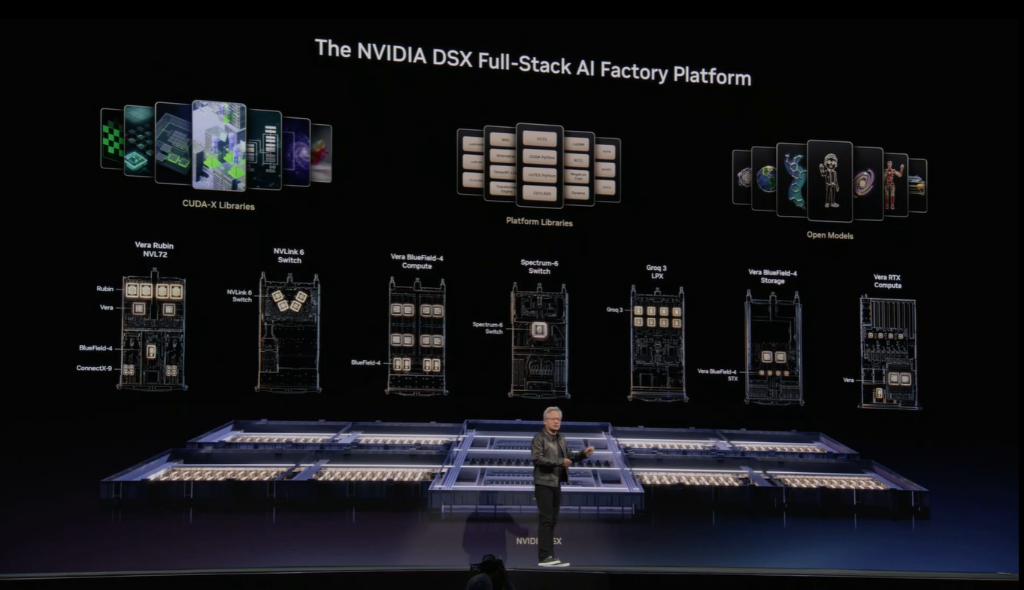
英偉達發佈的DSX POD是基於Vera Rubin架構的完整AI工廠參考設計。其核心邏輯在於,將計算、網絡、佈線、機架級供電及液冷系統的集成安裝工作,從現場施工轉移至製造工廠。合作伙伴在發貨前完成機架間線纜連接、電氣佈線、管道安裝和功能驗證,集裝箱運抵現場後只需接入預先準備好的電力、冷卻與網絡設施,即可投入使用。
黃仁勳表示:
"AI工廠在開始生產token時創造價值,而不是在建設完工時。藉助DSX POD,我們將工廠級精度和速度帶入AI基礎設施建設,把部署時間從數月縮短至數週,使客戶能夠更快擴展容量並讓可創收的生產上線。"
需要指出的是,14天指的是場地已完成準備情況下的現場部署時間,不包含從選址到建成的完整週期。客戶仍需提前完成電力、冷卻、網絡等支持設施的準備工作。英偉達計劃與戴爾科技、HPE、聯想、Bull、施耐德電氣、維諦技術等合作伙伴,於2027年初在全球交付基於DSX POD設計的模塊化AI工廠。
在能效層面,DSX AI工廠平台採用閉環液冷和乾式冷卻器,將冷卻用水量降至接近零,在2吉瓦規模下每天可節省高達5400萬升水;DSX MaxLPS軟件則可幫助運營商在相同token輸出下減少最多30%的功耗。
OpenShell:以硬件級隔離管控AI智能體行爲
隨着智能體部署規模擴大,英偉達推出OpenShell參考架構,專門應對智能體安全問題。該架構整合Vera Rubin基礎設施、Vera CPU、BlueField-4數據處理器,以及OpenShell安全運行時軟件,通過在系統調用、文件訪問和網絡連接粒度上執行策略,限制智能體可訪問的資源範圍。
核心機制是運行在BlueField-4上的NVIDIA Sentry安全框架,該框架在硬件隔離的可信域中持續監控智能體行爲,一旦檢測到異常操作,可在毫秒級將其隔離並切斷其與模型的連接。英偉達稱,Vera Rubin NVL72系統在智能體工作負載下的每兆瓦吞吐量可達此前的30倍,NVIDIA Sentry則可將智能體承載能力提升最多20%。
OpenShell採用Apache 2.0許可證開源,支持Linux、Kubernetes、微軟Windows等企業環境,並可擴展至邊緣設備。微軟、谷歌雲、戴爾科技、思科、OpenAI、Anthropic等已宣佈參與相關合作,其中Anthropic與英偉達正合作開發Claude OpenShell智能體。
機器人與自動駕駛:多家歐洲車企及機器人公司加入生態
在物理AI領域,英偉達披露,今年上半年相關市場營收同比增長約30%,至約110億美元。
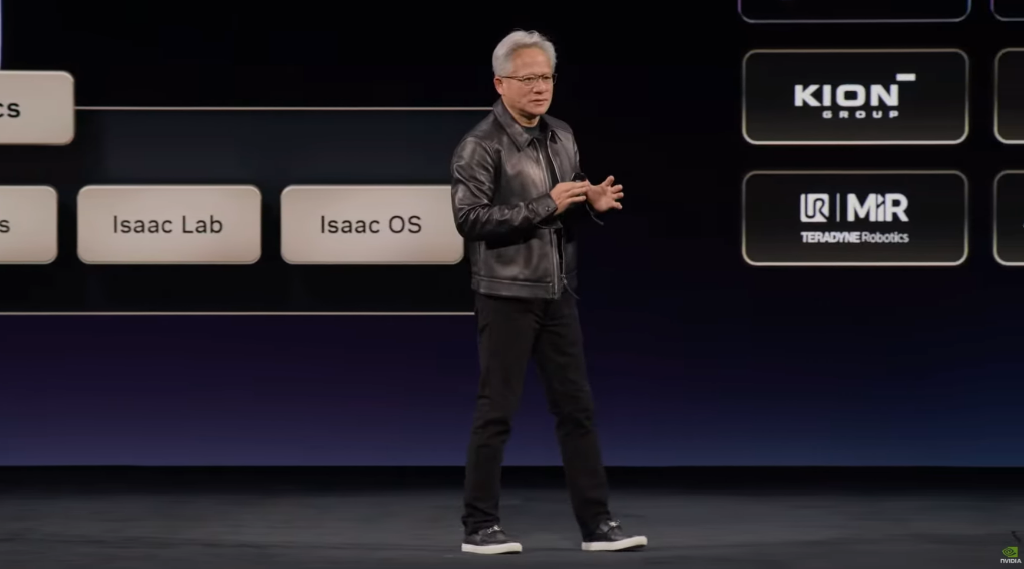
在機器人方向,英偉達宣佈擴展Isaac開放機器人開發平台,推出開源運行時框架Isaac OS、機器人學習框架Isaac Lab 3.0,以及包含2000餘種仿真就緒機器人和工廠資產的SimReady Central Library。同時,英偉達與思靈機器人合作推出人形機器人蔘考平台Agile One SN,內置Jetson Thor計算硬件,預計明年第一季度上市。黃仁勳表示:
"通用機器人正以驚人的速度進步——機器人的ChatGPT時刻正快速臨近。"
在自動駕駛領域,沃爾沃汽車將採用英偉達Hyperion計算平台及Alpamayo自動駕駛軟件棧開發自動駕駛汽車;大衆將英偉達產品用於商用車;Bolt Technology則基於英偉達軟件及硬件推進Robotaxi業務,計劃2027年起在馬德里採集真實駕駛數據,並規劃在歐洲部署至少2.5萬輛具備L4自動駕駛能力的車輛。此外,梅賽德斯-奔馳將利用Hyperion平台開發L3和L4級自動駕駛能力。英偉達還推出Halos SAFE安全評估框架,將仿真、軟硬件在環測試、道路測試和車隊監測納入統一評估流程。
醫療與生物醫藥:從放射治療到蛋白質設計
英偉達在醫療健康領域宣佈多項合作。與西門子醫療旗下癌症治療業務合作,探索將智能體AI、患者個體化仿真及實時計算應用於自適應放射治療,相關係統將實時監測患者呼吸與體位變化並動態調整放射劑量。
在生物醫藥方向,英偉達與華盛頓大學醫學院蛋白質設計研究所合作推出開放模型BioNeMo RFD4-Proteina,可根據分子輸入、設計約束和評分目標生成並優化蛋白質設計方案,應用場景涵蓋藥物研發、疾病檢測及工業酶開發。
開放模型與基礎設施:佈局歐洲本土AI生態
面向歐洲企業和研究機構,英偉達宣佈擴充開放模型產品組合,新品涵蓋Nemotron 3.5系列語言與視覺模型、面向結構化商業數據分析的Kumo模型、用於機器人訓練與仿真的Cosmos世界模型、面向自動駕駛邊緣推理的Alpamayo 2 Edge,以及用於量子計算的Ising模型。
黃仁勳將AI經濟比作由能源、算力、AI工廠、模型與應用五層構成的結構,並指出歐洲AI基礎設施建設正在加速。他預測,未來所有電信運營商都將提供AI算力,現有電信基站有望逐步演變爲分佈式AI網絡。在合作伙伴層面,Nscale、Firebird等AI數據中心建設商,以及Mistral、Legora、DeepL等歐洲AI模型與應用公司,均被納入其展示的AI經濟生態圖譜。
以下爲黃仁勳在英偉達2026年柏林GTC主題演講全文:
黃仁勳:
2020年,我們開始與梅賽德斯-奔馳合作開發自動駕駛汽車。回顧英偉達33年的發展歷程,我在德國度過了很多時間。因此,我很高興再次來到這裏,也很高興今年能在這裏舉辦GTC。
過去一年,我們開啓了一段新的旅程:在歐洲建設一個新產業,推動AI經濟起步。
僅在過去一年,我們就在歐洲投資了近100億美元,涵蓋初創企業,以及遍佈歐洲的大大小小的合作項目。
就在過去一週,我從法國、英國來到瑞典,再來到柏林。期間,我們宣佈投資了14家初創企業。迄今爲止,我們在歐洲建立了超過12,000項合作關係,大家都在朝着同一個目標努力。
計算機產業經過數十年的發展,如今,我們正站在一場新工業革命的起點。
這張圖片是計算機生成的,提示詞由我提供。我只是簡單描述了「AI推動新工業革命」,再列出幾家希望突出展示的合作伙伴,它就生成了這幅畫面。
非常有意思的是,在AI的理解中,建設一個新產業,意味着生成Token、生產智能,再把智能融入每一個行業,推動新的工業革命。
當一項新技術改變了我們如何製造產品,以及我們能夠製造什麼產品時,一場新的工業革命就會發生。
我認爲,人工智能將在各個方面影響我們製造的一切,並讓我們能夠創造過去無法創造的新事物。
每個人都會使用它,每家公司都會由它賦能,因爲它是數字智能,是一切的基礎。每個行業都會因此改變,新的行業也會誕生。
就像電力一樣,AI將帶來一場新的工業革命,而我們才剛剛起步。
問題是:什麼是AI?
如果你希望參與創造這個未來,理解AI究竟是什麼,至關重要。
我們很早就意識到,AI實際上是一個製造產業。
它不僅是一項軟件技術。AI當然運行在計算機上,但這種計算機的運行方式已經發生了根本變化。它不再僅僅是供我們使用的工具,而是成爲機器、基礎設施和工廠的一部分,用來生產智能,再將智能融入每一個行業和應用。
一個簡單的理解方式,是把AI看作一塊五層蛋糕:
能源驅動先進計算機;這些計算機構成AI工廠;運行在工廠中的模型生成Token,也就是數字智能;這些智能再融入各種應用。
要參與AI經濟,你不應該只消費AI,也應該生產AI。這些事情,我們都可以在歐洲完成,而且已經開始了。
歐洲正在建設自己的AI經濟,圖中展示的就是這五個層次。我們擁有出色的合作伙伴。觀察這五層結構,你會發現,這確實是一個新產業,因爲每一層都在增長。
我們正在以驚人的速度創造就業和增長機會。歐洲的施耐德電氣、西門子、西門子能源等公司,在全球都有出色表現。
英偉達處於計算層,我們的技術被集成到歐洲各地不斷湧現的AI工廠中。NEBIUS等新興企業發展得非常好;一家名爲Firebird的新公司正在中亞地區建設新的雲平台,非洲也有Cassava這樣的企業。
我預測,未來每一家電信運營商都會向AI轉型。大量通信站點及數據中心構成的分佈式基礎設施,將演變爲分佈式AI網絡。原稿所述規模爲約10萬個站點、約100吉瓦。
AI基礎設施正在建設,其上才是AI模型。
必須認識到,在模型出現之前,基礎設施就必須先存在。就像擁有互聯網之前必須先建立網絡,要享受電力的能力,必須先建設電廠、讓住宅接入電網一樣。
模型層也不只有語言模型,還包括生物、化學、物理、機器人動作和動畫等模型,而且規模各不相同。
不同產業將由不同模態的AI模型驅動。這些模型進一步融入AI原生企業和初創公司,而歐洲有大量這樣的企業。
歐洲的AI經濟已經起步,而且正在加速發展。
談到英偉達在底層的貢獻,多數人首先想到的是GPU,這當然沒錯。
1993年,我們從圖形芯片起步,後來發展出GPU和可編程着色GPU。隨後,我們加入CUDA加速能力,重新定義了計算,並推動了人工智能的發展。
但今天的英偉達,實際上已經是一個覆蓋全棧、端到端的完整AI工廠平台。多年來,我們的技術範圍已經大幅擴展。
我們的技術包括GPU計算,最新一代是Vera Rubin;包括將多顆GPU連接成一顆巨大GPU的NVLink交換機;包括最近推出的Vera和BlueField-4,稍後我還會介紹。
還有我們的以太網解決方案Spectrum-X,它使英偉達成爲如今全球最大的網絡公司。
還有用於文本及Token生成的解碼加速器Groq 3。
此外,還有基於Vera和BlueField-4的存儲加速,以及Vera RTX計算。稍後我會分別介紹。
這些技術共同構成了建設AI工廠所需要的硬件體系,但如果沒有軟件將其激活,一切都無法工作。
首先是運行AI工廠的系統軟件。
這些系統極其龐大。一座1吉瓦的數據中心,也就是一座1吉瓦的AI工廠,成本大約爲500億美元。這包括土地、電力、建築,以及計算、網絡、存儲、供電和冷卻設備。
所有設備連接起來,形成佔地數英畝的AI工廠。僅僅讓它啓動並正常運行,本身就是一項壯舉。
讓這座工廠運轉、投入使用並生產Token,需要海量軟件,這是一項非凡的工程。英偉達提供完整的全棧軟件。
其上是我們稱爲CUDA-X的庫,也就是英偉達的算法體系。
從本質上說,英偉達是一家算法公司,我們設計芯片來加速這些算法。
其中之一是cuDNN。很多研究人員認爲,這個庫推動了現代AI的大爆發。
cuDNN之於AI,就像SQL之於全球數據庫產業。它是面向特定領域的語言和庫。
就像OpenGL和DirectX推動了實時計算機圖形的發展,cuDNN推動了AI計算產業的發展。
除此之外,我們還有350個其他庫。這些庫才是公司的核心資產,覆蓋計算光刻、信號處理、圖像處理、數據處理、粒子、流體、稀疏求解器等廣泛領域。
在座許多人的公司已經接入了這些庫。
我們通過這種方式開拓新市場,將英偉達與各種算法連接起來,讓大家以極高速度完成計算。
最右邊則是模型。
模型是新的軟件,也是新應用的引擎。它們建立在CUDA-X庫之上,並與這些庫協同工作。
英偉達一直在多個領域開發這些模型,它們將開啓新的機會,稍後我會詳細介紹。
回顧AI時代的各代產品,我們從Pascal開始。
基於Pascal的DGX-1,是世界上第一臺AI超級計算機。我在十年前發佈它,並將第一臺交付給OpenAI,開啓了他們的計算發展歷程。
從Pascal到Volta、Ampere,再到很多人第一次聽說英偉達時接觸到的Hopper,然後是當前的Blackwell,以及如今已全面投產的Vera Rubin。
這是六代架構。每一代,我們都在推動技術進步。
過去十年,我們將AI性能提高了100萬倍。
退一步想,如果只依靠摩爾定律,十年會發生什麼?前五年提高10倍,後五年再提高10倍,合計約100倍。
而在同一時期,我們通過所謂的「極致協同設計」,同時在計算機架構和軟件棧各層開展創新,優化算法、創造新算法,並設計相應架構來加速它們,最終將AI性能提高了100萬倍。我們還會繼續這樣做。
這就是今天英偉達所構建的技術體系,也是我們幫助歐洲參與AI生態和AI經濟的基礎。
早期的Pascal、Volta、Ampere和Hopper,主要圍繞GPU展開。我們創造了新的DGX形態。
到了Blackwell,我們向世界推出了首個機架級計算系統。
機架級計算把一整套系統變成一臺巨大的計算機,或者說一顆巨大的GPU。
到了Vera Rubin,我們進一步擴展計算範圍:不再只處理模型或大語言模型,而是處理整個智能體。
稍後我們還會回到這張圖,但請記住:智能體需要思考,而模型承擔的就是這部分工作。
感知、推理、規劃和工具使用,都依賴大語言模型,模型也是爲這些能力而設計的。
但智能體還需要一個運行框架,也就是Harness。你可以把它理解爲數字智能體的外骨骼。
就像人有大腦,也有身體,智能體框架負責協調工作,讓智能體能夠調用記憶,包括活動記憶、工作記憶和長期記憶,並使用工具。
第三部分是處理知識的計算機,專門負責數據處理。
最後,還有一類專門運行CUDA-X庫的計算機,負責執行工具。
這些計算機共同構成完整的智能體系統。
Vera Rubin已經全面投產。我們來看看實物。
這是我們打造的第一款沒有外露連接線纜、採用100%液冷設計的計算機。它可以直接抽出來,非常方便。
這就是一臺Vera Rubin計算機,這個單元有兩顆GPU。
過去,組裝一個Grace Blackwell節點需要兩個小時。你看過實物就會明白,到處都是線纜,它採用約80%的液冷設計。
現在,Vera Rubin實現了100%液冷,組裝時間不到五分鐘。
這是了不起的進步,意味着更短的製造週期、更高的可靠性,以及更好的性能。
這是NVLink交換機托盤。它將72顆GPU連接起來,形成一顆巨大的GPU。
每顆GPU的性能爲20 PFLOPS,再將72顆連接成一個龐大的系統。
這是我們的新款Vera計算機。
[現場出現插話]
沒關係,溫和一點,讓她有機會說話。每個人都有表達的機會。不過今天,先讓我完成演講,我稍後會和你們交流。
這些都是重要的問題,但請讓我先講完主題演講。
這個會場已經坐滿,全球還有100個同步觀看活動,現在有15,000人正在觀看。
最後我準備了一些非常有意思的內容。在娛樂環節到來之前,大家得先忍受一下我的知識講解。
這是全新的Vera計算機。Vera CPU是一顆非常強大的處理器,每個時鐘週期能夠執行八條指令。
它採用了我們所說的全球首創LPDDR內存子系統,兼具高性能、極高帶寬和出色的能源效率。
它的片上互連速度在全球芯片中處於領先水平,因此,數據處理,以及智能體會話的啓動和執行性能,都非常出色。這正是它的設計目標。
這就是Vera計算機。
旁邊這套是Spectrum-X,採用共封裝光學,也就是CPO技術。我給大家看看。
舞臺上有些地方是空的,有些地方可以踩,我不太確定分別在哪裏。如果我突然消失了,大家要知道,那不是特技,是意外。
這裏是激光器。光信號通過光學連接直接進入芯片。
我們與台積電共同開發了一項名爲COUPE的工藝,讓硅光子器件能夠直接連接到芯片上。
否則,這一整塊區域都需要通過印刷電路板傳輸信號,而電路板的傳輸能力遠不如光纖。
現在,我們可以讓極高數據速率、高質量的信號直接到達芯片,減少傳統方案中通過電路板和收發器進行轉換的環節。
這是我們的CPO產品,已經進入全面量產,提供512個端口,每個端口的速率爲200Gbps。
這是全球最先進的以太網交換機,我們對此非常自豪。
這些系統讓我們能夠處理大語言模型的思考過程,運行智能體框架,處理智能體所需的知識數據,並通過加速計算運行各種工具。這些基本上構成了智能體的完整工作負載。
Vera Rubin已經全面投產,性能非常出色。
正如我所說,每一代產品,我們都通過極致協同設計,實現遠超摩爾定律所能帶來的性能進步。
大家知道,摩爾定律在很大程度上已經走到盡頭。因此,我們需要從芯片到系統、從系統軟件到算法,再到整個AI工廠,開展這種協同設計。
Vera Rubin在Blackwell的基礎上又邁出了一大步。
在大語言模型處理方面,Blackwell的性能約爲Hopper的30倍。而僅僅兩年後,Vera Rubin又達到了Blackwell的約30倍。
接下來看看,Vera Rubin如何構成DSX全棧AI工廠。
視頻旁白:
AI正在推動歷史上規模最大的基礎設施建設。
工廠規模龐大,投資金額巨大,我們必須把它建好。但只有優秀的芯片,還不足以構成優秀的AI工廠。
NVIDIA DSX是與全球領先基礎設施企業共同開發的全棧AI工廠參考架構。
計算、網絡、存儲、軟件、供電和冷卻作爲一個整體協同設計,從設計階段到實際運營全面優化。
DSX從數字孿生開始。
在施工之前,先在虛擬環境中驗證性能、功耗、用水量及擴展能力。
PTC將設備設計轉化爲可用於仿真的資產。
達索系統通過基於模型的系統工程,將機架設計與設施設計連接起來。
施耐德電氣模擬配電和液冷系統。
Jacobs將這些內容整合進Omniverse數字孿生。
西門子評估熱、聲學及電網影響。
Procore支持施工階段的規劃。
電力決定AI工廠能夠生產多少智能。
DSX Max LPS是一套端到端控制迴路,能夠根據工作負載需求動態分配電力,在實現相同產出的情況下減少30%的用電量。
DSX也重新設計了冷卻方式。
NVIDIA Vera Rubin系統採用閉式液冷,在適宜氣候條件下,冷卻液溫度可以高達45攝氏度。室外乾式冷卻器將熱量釋放到空氣中,不需要蒸發水。
對於一座2吉瓦的設施,DSX每天可以節省5,400萬升水,相當於18萬戶家庭的日用水量。
然而,建設AI工廠可能需要數月時間。在投運之前,它不會生產任何Token。
今天,我們發佈NVIDIA DSX Pod,將這一全棧平台整合成在工廠內製造的一體化系統。
它以Vera Rubin NVL72爲基礎。
七個液冷計算機架,通過17公里的Spectrum-X線纜連接,構成一個Vera Rubin DSX Pod。
整個Pod在工廠完成集成、佈線和測試,再裝入可運輸的集裝箱交付。
乾式冷卻器取代傳統蒸發冷卻系統,800伏直流電直接連接機架,提高供電效率。
只要現場基礎設施就緒,預計現場部署時間就能從數月縮短至數天。
NVIDIA DSX AI工廠從設計階段就考慮資源效率和責任。現在有了DSX Pod,AI工廠的建設速度將大幅提升:每瓦電力產生更多智能,從交付到生成首個Token所需的時間也更短。
黃仁勳:
大家覺得怎麼樣?
2016年,我們發佈了世界上第一臺AI超級計算機。當時,它是一臺單節點GPU系統。
三年前,我們推出了Grace Blackwell NVLink 72機架級計算機。
這兩次創新,我們不僅重新設計了計算機、軟件和運行方式,也重新設計了供應鏈。
以NVLink 72爲例,過去整個機架需要在現場組裝,現在我們把組裝工作移到了供應鏈內部。
本質上,我們實現了超級計算機的規模化製造。
這正是我們能夠如此快速行動,同時支持全球數百個數據中心建設項目的原因。
如今,全球所有主要計算機制造商都在製造NVLink 72。我們生產計算系統的規模,是過去從未有過、難以想象的。
即便如此,當這些系統運抵現場後,仍然需要數月時間進行組裝。
剛才大家聽到了,僅用於橫向擴展計算的Spectrum-X連接,就需要17公里線纜。
假設我們把這些工作全部放到供應鏈內部完成:組裝系統、啓動運行、驗證完整功能、完成質量認證和老化測試,確保出貨時已經能夠正常工作。
這樣,現場佈線和組裝量就會大幅減少。
但更重要的是,數據中心裏等待安裝調試、無法投入使用的閒置算力,也會顯著減少。
記住,每座1吉瓦數據中心的成本約爲500億美元,預期每年可創造數百億美元收入。
假設這套基礎設施每年能夠創造400億美元收入,僅僅延遲三個月,就意味着100億美元收入推遲實現。這足以讓任何人感到焦慮。
通過將這些工作轉移到供應鏈內部,從計算設備到貨、安裝,到正式生產Token的時間,有望從四五個月縮短至大約一個月。
這將徹底改變全球供應鏈,也會改變人們安裝和建設數據中心的方式。
我們希望,這能提高建設和投運速度,減少閒置算力及閒置資本支出的浪費,讓所有參與者獲得更好的盈利能力。
這就是將NVLink 72進一步集成爲大型機櫃系統的DSX Pod,也是英偉達計算系統發展的下一步。
你製造什麼,以及如何製造,決定了你的獨特之處。
就像歐洲企業,你們掌握的專業能力讓你們與衆不同:你們設計機器、運營工廠、發現藥物,擁有非凡的工藝和專業知識。
英偉達的獨特之處主要有兩點。
第一,我們的架構是一種通用加速計算架構。
我們不只針對一種算法,例如Transformer,而是支持各種可以並行處理的工作負載,包括流體、粒子、量子計算、量子化學、圖像處理、數據處理,以及結構化數據和向量數據處理。
由於我們長期投入,而且架構在過去約25年裏保持一致,我們支持和加速的算法、領域及行業數量持續增長。
龐大的裝機基礎、通用架構、長期投入,以及與各行業的合作,讓英偉達架構幾乎無處不在。
第二,是我們的實現方式。
我們不僅開發架構,還將其構建成完整的全棧AI工廠。
世界上有不少公司希望自行設計芯片,但絕大多數公司只是希望部署AI基礎設施,然後在其上運行自己的業務。
設計芯片、製造超級計算機、編寫全部軟件,對大多數企業來說都不是它們打算承擔的工作。
因此,CUDA與全棧AI工廠的結合,使我們能夠服務過去難以觸及的市場。這也是我們能夠與這裏衆多企業合作的原因。
從雲服務提供商,也就是CSP開始,多數人認爲今天絕大部分AI都集中在那裏。但在演講開頭,我提到的很多公司並不屬於傳統CSP。
CSP仍然是全球計算市場的重要組成部分,但與此同時,世界各地正在湧現AI原生企業。
還有新型AI雲服務商,也就是Neocloud。每個地區都希望參與AI經濟,希望將自身擁有的寶貴資源和能源用於支持本地區企業。
例如法國的Mistral、歐洲的NEBIUS,以及歐洲各地建設新型AI雲的公司。
還有爲全球企業製造計算機的OEM和ODM廠商,以及AI實驗室。
去年,我們大量討論OpenAI;如今,除了OpenAI和Anthropic,還有Meta、Grok、Gemini等參與者,越來越多AI實驗室正在推動前沿技術發展。
但最重要的是,如果AI要真正成功,如果歐洲要從AI中受益並建立完整的AI生態和AI經濟,那麼所有終端行業都必須採用AI,並通過AI取得成功。
無論是開發自動駕駛汽車的汽車行業、使用機器人進行製造的工業企業、通過AI發現新藥的醫療行業,還是金融服務業,每個行業的企業都需要成爲AI公司。
藉助CUDA以及我們的計算機制造方式,我們能夠服務AI的各個細分領域。
一種架構,覆蓋多個市場。
這些基礎設施規模巨大、成本高昂,因此必須儘快發揮最大生產力,而且能夠靈活用於各種工作負載。
從AI旅程最初的數據處理,到訓練、後訓練、推理和智能體處理;從化學、物理到語言;從各個行業到它們使用的各種算法,都應當由同一套基礎設施支持。
因此,英偉達架構具有很強的通用性和可調配性。
持續創新、持續軟件更新,以及龐大裝機基礎所形成的豐富軟件生態,又讓這套架構具有長期使用價值。
通用、耐用、高效,這就是基礎。
有了這些基礎設施,我們能做什麼?
過去一年,AI發生了轉變,開始真正創造生產力。
其中一個重要時刻,是年初我們談到OpenClaw,它將開源智能體的概念帶給了更多人,也推動了如今全球正在發生的變化。
智能體會思考、推理、迭代和使用工具,因此會消耗大量Token。但也正因如此,它們開始真正有用。
更多智能體被開發出來,因爲更有用,所以更多人使用;又因爲思考需要大量Token,Token消耗迅速增長,GPU需求也隨之大幅上升。
這張圖展示的是一個智能體的五個組成部分。
第一是語言模型。模型運行在GPU上,生成供智能體使用的Token。
第二是我所說的「外骨骼」,也就是智能體框架,例如OpenClaw。
框架運行在沙箱內,沙箱將它與系統其他部分隔離。這是一個非常重要的概念。
另外兩個部分是知識和工具。
模型、框架、沙箱、知識和工具,構成了智能體的五個要素。
在討論如何讓智能體變得有用之前,首先必須確保它是安全的。
智能體是自主系統,可以訪問文件、資源、網絡和工具。因此,我們必須賦予它最小必要權限,並持續監控其行爲。
爲此,我們推出了一個新平台:OpenShell。
OpenShell是一個安全運行時,提供剛才提到的能力,並可以配合額外的硬件監控機制。
在詳細解釋之前,我們先看一段視頻。
視頻旁白:
企業正在準備部署數十億個AI智能體。
爲了發揮作用,它們需要推理、規劃、使用工具、訪問數據並相互協作。
但如今,阻止智能體濫用這些能力的方式,往往只是告訴它:
「請不要刪除任何東西。」
「請不要向主分支推送代碼。」
「請不要碰我的SSH密鑰。」這就是「請不要」的安全方式。
但希望不等於安全。安全不是願望,而是技術和工程。
NVIDIA OpenShell和Sentry將這一理念落實到實際系統中。
你爲每個智能體編寫策略,規定它可以接觸什麼。OpenShell在系統調用、文件訪問和網絡連接層面執行這些策略。
形式化驗證會檢查每一次策略變更,確保其不突破你設定的權限上限,使智能體不會獲得超出預期的訪問權限。
這類似於早期互聯網:在瀏覽器嚴格限制網頁能力之前,病毒曾經四處傳播。OpenShell爲智能體建立類似的邊界。
這些限制在智能體之外執行,而不是隻依賴大語言模型內部的護欄,從而將智能體原生安全能力引入基礎設施。
每個智能體都運行在自己的隔離沙箱中,不能直接訪問網絡。
所有出站網絡請求,都必須經過沙箱外的監督組件。監督組件根據策略檢查請求,未獲允許的操作會被拒絕。
密鑰保存在沙箱外,由監督組件管理,只有向獲准訪問的端點發送請求時才會加入。即使智能體遭到入侵,也無法泄露它從未持有的密鑰。
網關充當控制平面,監督組件負責作出決定,沙箱容納智能體,策略證明器則檢查擬議策略是否符合權限上限。
OpenShell將Linux內核隔離與運行時策略執行相結合。
NVIDIA Sentry還可以在主機之外、遠離智能體的位置,增加一層可選保護。
Sentry運行在NVIDIA BlueField-4上,在硬件隔離的信任域中監控智能體活動並執行安全策略。
智能體的推理流量經過Sentry,因此一旦檢測到需要阻止的計劃,系統可以立即更新策略,切斷智能體與模型的連接,在毫秒內完成隔離。
它還保留可驗證、防篡改痕跡的記錄,供運營人員進行檢測、調查和響應。
OpenShell採用Apache 2.0許可證開源,可運行在智能體所在的各種環境中,從邊緣到雲端。只需兩個命令即可開始使用:安裝命令行工具,創建沙箱,然後運行你喜歡的智能體。
智能體能發揮多大作用,取決於你賦予它多少訪問能力。OpenShell和Sentry讓這些訪問能力處於你的控制之下。
這就是我們同時推進AI能力與安全的方式。
黃仁勳:
智能體是自主系統。我們必須創造高度安全的技術,確保能夠安全地開發和部署它們。
OpenShell發佈後,從前沿模型實驗室,到操作系統公司、網絡安全公司和平台公司,許多大型企業都開始採用它。
因爲這項技術到來的時機恰到好處:我們正準備在全球大規模部署智能體。
這不僅關乎服務提供商在部署智能體時使用OpenShell,也關乎世界各地的企業採用OpenShell,讓這些智能體能夠在企業內部自主運行。
不同能力、不同任務、不同使用者,對應不同的權限需求。每次啓動智能體,所需要的權限可能都不一樣。
因此,權限配置、策略執行和監控,都必須動態完成。
我很高興宣佈,Anthropic與英偉達正在合作,將Claude智能體與OpenShell結合。網站上有一篇很好的介紹文章。
你可以使用OpenClaw、Hermes、OpenHands,也可以通過LangChain、Deep Agents構建自己的框架,甚至直接用Python編寫。
這些智能體框架都可以運行在OpenShell提供的安全沙箱中。
接下來談模型。
未來,我們不會只用一個模型處理所有工作,而是會根據任務選擇最合適的模型,無論它是閉源、開放還是定製模型。
有些工作相對通用,通用人工智能就能做得很好。
但另一些工作包含大量專有知識和專業能力,而且你希望持續提升這些能力。
因此,未來每家公司都會同時使用閉源模型,以及自行定製的開放模型。
到今天演講結束時,大家會發現,構建自己的AI並沒有那麼困難。
首先當然是模型。
我們一直致力於推動開放模型的發展,開拓新機會,讓大家能夠構建自己的定製AI。
Nemotron面向語言。
Cosmos是我們的世界基礎模型,我們在這一領域處於前沿。
GR00T面向人形機器人。
Alpamayo面向自主導航。
Ising面向量子—經典混合計算。
Earth-2面向物理AI。
在這些不同領域,我們都提供模型,並持續投入研發。我們已經做了十年,也會長期做下去。
我們不僅開放模型,還提供相關數據,讓你了解模型的數據來源,並提供復現所需的腳本。
因此,你得到的不只是開放權重,而是完整的方法、數據和復現路徑。你能夠知道模型從何而來,並建立對它的信任。
這些模型未必在所有領域都是最前沿的,尤其是在語言模型方面。
但通過定製,以及與生態夥伴合作,你可以將它們提升到自己所需領域的前沿水平,把專有數據轉化爲自主掌握的智能。
例如,AI21幫助Alice將Nemotron定製爲超越相關前沿能力的模型。
Baseten幫助CodeRabbit使用自身數據微調Nemotron,實現前沿水平的能力。
Trajectory與Harvey也通過對Nemotron進行後訓練,構建自己的前沿能力。
Scale與Skydance同樣在做這樣的事情。
例子還有很多。
核心在於,你可以從Nemotron這樣優秀的開放模型出發,用自己的數據針對特定用例進行後訓練,從而獲得高度專業化的智能。
這是一條非常合理的路徑,所需技術今天都已具備。
這裏還有Palantir與坦帕綜合醫院的案例。
我們擁有豐富的合作伙伴生態,能夠幫助大家。這些都是出色的公司,可以爲世界各地的客戶提供服務。
我如果只提一家,就會漏掉其他夥伴;如果全部列出來,又要花很長時間。我非常珍視所有這些合作伙伴。
總結一下:首先,讓智能體框架運行在OpenShell安全沙箱中;其次,選擇Nemotron等大語言模型。
但真正讓普通智能體變成「超級智能體」的,是讓它訪問你公司的知識。
我們將這套能力稱爲智能體知識基礎。
它由一組世界級模型和工具組成,幫助你處理公司的各種數據資產。
數據可能以非結構化形式存在於文檔中,因此需要AI理解PDF和其他非結構化文件;也可能以結構化形式存在於數據庫中。
我們提供必要的庫和工具,幫助你從企業數據中提取含義、形成理解。
Nemotron Parse負責文檔解析,表現位居相關排行榜前列。
Nemotron Embed將查詢與向量數據庫中的知識關聯起來,同樣具有領先表現。
Nemotron Rerank則處理檢索到的多個來源和數據片段,根據與查詢的相關程度重新排序。
Kumo可以利用結構化數據庫預測可能發生的事情。
舉例來說,你收到供應商通知,某些物料將出現短缺或交付延遲。這條信息很可能是一份非結構化文檔。
而公司訂單信息通常保存在SQL等結構化數據庫中。
如果要預測哪些訂單會受影響、哪些會缺貨、延遲多久,可以使用Kumo。
接下來,爲了尋找替代零件,你可以使用向量數據庫檢索,找到相關替代部件的工程文檔。
這些模型、庫和數據處理能力,共同構成知識基礎,讓AI能夠利用你的專有數據和專有知識。
最後是工具,也就是完成專業工作所需要的工具。
英偉達一直在開發CUDA-X。
在AI成爲主要話題之前,我們的大量討論都圍繞着如何加速模擬器、求解器、數據處理引擎,以及各種領域專用庫展開。
這些工具用於各個科學領域的發現,也用於工程、研究、設計、建造和創意藝術。
它們的核心是CUDA-X庫,而CUDA-X庫本質上是算法。大家知道,算法是美的。
我們來看一段展示。
數學很美。
CUDA-X庫是我們公司的核心資產。原因在於,當你構建AI助手時,無論它是實驗室助手、研究助手,還是與你共同設計和創造的夥伴,最終讓它真正有用、能夠完成實際工作的,都是工具。
現在,我們擁有能夠讓智能體理解信息、推理、規劃,並不斷採取行動、使用工具直到完成任務的模型。
但最終,仍然離不開工具。
這些工具,我們已經開發了很多年。
剛才展示的右側那類計算機,可以運行所有這些工具,無論是流體動力學、粒子物理、量子化學、數據處理,還是光線追蹤。
與直接在CPU上運行相比,它可以將處理速度提高10倍、50倍,甚至100倍。
CUDA-X給智能體提供了完成專業工作的能力。看到其他人如何使用這些工具,非常令人興奮。
這就是智能體背後的關鍵。
智能體最終需要使用工具。
軟件編程是最早採用智能體的領域之一,在那裏,編譯器或Python往往就足以完成很多工作。
但未來,隨着智能體承擔越來越多實際任務,我們需要爲它們提供更多工具。
下面是幾個例子。
Lila Sciences正在開發實驗室助手,使用英偉達的BioNeMo模型理解蛋白質和細胞,並在藥物發現中設計蛋白質及化學分子,同時調用CUDA-X工具。
西門子正在構建工廠智能體,使用理解物理世界的Cosmos世界基礎模型,以及CUDA-X工具。
達索系統則在開發虛擬夥伴,使用Nemotron語言模型和CUDA-X工具。
來看看它們如何工作。
視頻旁白:
最聰明的科學家仍然需要實驗室,最優秀的工程師仍然需要模擬器和求解器,AI智能體也是如此。
一個智能體由五個部分組成:
模型負責感知、推理和規劃。
框架負責協調工作。
知識基礎從公司的結構化和非結構化數據中提供上下文。
工具讓智能體能夠模擬、實驗和採取行動。
NVIDIA OpenShell控制智能體可以訪問和執行什麼。
你可以從前沿閉源模型開始,也可以定製開放模型。藉助NVIDIA Agent Toolkit,任何公司都能將自身知識和專業能力轉化爲定製超級智能體。
來看三個例子。
對於Lila Sciences,目標是設計一種針對B細胞淋巴瘤的療法。
基於Nemotron構建的Lila Iris智能體,將這一目標轉化爲實驗計劃。
在計算幹實驗室中,Lila智能體使用NVIDIA BioNeMo Agent Toolkit,調用蛋白質設計和RNA優化模型,運行數百萬次虛擬實驗。
最有前景的候選方案進入Lila的AI科學工廠,由藉助Omniverse和Cosmos開發的自主機器人及儀器進行製備和測試。
結果返回Iris,影響下一輪設計和實驗,形成持續迭代的閉環。
在西門子埃爾朗根電子工廠,目標是讓新產品投入生產。
Process Preparation X智能體使用Cosmos生成虛擬原型和合成數據,在生產開始前訓練並驗證檢測模型。
基於NVIDIA工廠運營藍圖構建的Intelligence Center X智能體,根據訂單、物料供應和產線配置,提出生產計劃建議。
Digital Twin Composer利用Omniverse庫,將物理仿真與實時工廠數據結合,在實際調整生產現場之前驗證這些計劃。
在達索系統平台上,一位工程師需要將大衆Golf的車門設計適配到Tiguan車型。
Aura和Leo使用Nemotron理解和推理工程要求。
智能體框架協調各個專業子智能體,並在規劃、設計和仿真過程中保留上下文。
Aura使用ENOVIA,根據車輛尺寸、重量限制和其他工程要求規劃工作。
Leo設計智能體選擇兼容的Golf車門設計,再使用CATIA修改形狀,使其適配Tiguan。
Leo仿真智能體使用由CUDA-X加速的SIMULIA測試不同方案,發現了振動問題。
結果返回設計智能體進行優化,工程師審核改進後的設計,並選擇最終方案。
不同的目標,不同的專業知識,相同的基礎組成:開放模型、CUDA-X加速工具,以及OpenShell安全運行時,通過NVIDIA Agent Toolkit整合在一起。
黃仁勳:
很棒,對吧?
有人說,AI來了,軟件和工具公司的時代就要結束了。
事實恰恰相反。
AI到來後,使用這些工具的用戶將比以往任何時候都多。
每一家工具公司都將成爲AI公司、智能體公司。它們不僅提供工具,還會提供經過專門優化、非常擅長使用這些工具的智能體。
Cadence、CrowdStrike、達索系統,以及其他許多企業軟件公司,都在構建智能體。我們很高興與它們合作。[原稿名單中另有一家公司名稱不清。]
構建智能體並沒有那麼困難。它有五個組成部分:模型、框架、OpenShell安全運行時,以及最重要的知識和工具。
模型和框架都有開放和閉源版本,而知識與工具屬於你,代表你的專業能力。
這些事情如今都已能夠實現。稍後我還會展示更多,但在此之前,先談談物理AI。
物理AI是AI的下一波浪潮。
它能夠理解物理世界,並對其進行推理。因爲物理世界多樣、複雜,存在極其豐富的長尾情況,AI需要理解這些情況,再使用合適的工具與物理世界互動。
一談物理AI,大家往往想到機器人。
但我最喜歡的應用之一,其實是移動通信基站。
它不是用攝像頭、揚聲器或麥克風,而是通過無線電波感知世界,處理信息並進行推理,再利用波束成形與世界互動。
因此,通信是一種非常適合AI的技術。
AI將徹底改變電信網絡,大幅提高頻譜效率。
就像我們在光線追蹤上所做的一樣:大家看到的圖形採用完整光線追蹤,而在引入AI之後,與過去認爲必要的計算量相比,效率出現了百萬倍量級的變化。
我們將爲電信網絡帶來巨大的頻譜效率提升。
除此之外,還將改變這些通信站點。原稿所述西方地區約有10萬個站點,構成約100吉瓦的分佈式數據中心基礎設施,未來將演變爲分佈式AI基礎設施。
我們很高興與歐洲衆多公司合作。
經過近八年的研發,就在上週,英偉達與諾基亞合作,在T-Mobile網絡上完成了首次商用通話。
現在,CUDA已經能夠執行傳統通信處理。在此基礎上,我們就可以進一步疊加AI能力,推動新的變革。
另一個讓我非常興奮的物理AI應用,是機器人輔助放射治療。
在治療過程中,腫瘤形狀可能變化,人體也會移動。這套自適應放療系統必須感知環境變化,識別腫瘤位置,精確分割目標,並據此準確引導放射治療。
本質上,這是一種機器人化治療。
當然,大家最熟悉、近期最有望實現大規模應用的機器人或物理AI領域,是我們已經投入十多年的自動駕駛。
我們意識到,每一家汽車公司都希望自己的車輛能夠加入出行服務車隊。
今天已有Uber、Bolt、Grab、Lyft等平台。未來,自動駕駛出租車也會接入這些出行服務,而且不會只來自一個品牌。
但開發這樣的系統,尤其是其軟件,成本非常高。
因此,我們決定創建一個標準架構。
這套架構包括14個攝像頭、9套雷達、3個激光雷達,以及一組超聲波傳感器。
這些傳感器形成一個環繞車輛的感知系統,由雙NVIDIA GPU系統提供自動駕駛計算能力。
我們將它發展爲行業標準,如今正在被越來越多車型採用。
自動駕駛軟件公司在其上開發能力,英偉達自己也是其中之一。這些自動駕駛出租車再接入出行服務平台,形成完整生態。
全球每年的出行里程約爲1萬億英里。未來,其中相當一部分里程可能由自動駕駛出租車完成,按每英里1至2美元計算,這是一個巨大機會。
但市場非常分散。
通過建立Hyperion這樣的標準架構,並與整個生態合作,我們就能形成一個巨大的虛擬車隊,讓各方都能接入。
今天,我很高興宣佈,又有四個品牌或車型系列加入:大衆廂式車、捷豹路虎的新車型、沃爾沃車隊,以及梅賽德斯-奔馳下一代車型。
它們將兼容Hyperion,併成爲這一自動駕駛出行網絡的一部分。
歡迎加入Hyperion。
下一個偉大產業,而且很可能規模極其龐大的產業,是人形機器人。
機器人之所以難做,一個重要原因是任務種類非常多。
如果針對每一種任務都開發一種特殊形態,就會把機器人產業分割成許多不同配置,難以形成推動技術進步的規模效應。
手機、個人電腦,以及英偉達NVLink 72之所以進步如此迅速,是因爲標準化配置可以服務大量客戶。
大量需求帶來規模,規模又推動技術迭代,讓產品更快、更好。
因此,我們需要儘可能標準化的機器人形態。
人形機器人未必適合所有任務,但很可能適合很多任務。因此,它可能成爲出貨量最大的機器人形態。
如果我們再爲它開發能夠快速學習的AI,那麼即使中小企業沒有專門的機器人團隊,也不必從頭編程,只需要向機器人演示要完成的工作。
機器人憑藉通用能力和通用智能,就能快速學習和適應。
這很可能成爲下一個重要技術平台。
我們正在與許多公司合作,其中不少來自歐洲。這是歐洲的重要機會。
歐洲在機電一體化、電子和機械系統的精度與工藝方面,擁有深厚積累。這裏有大量製造能力極強的企業。
機器人將成爲下一個大規模產業。許多公司已經參與進來,我們很高興與大家合作。
構建物理AI系統,需要三類計算機。
第一類,就是我們一直在談、大家也很熟悉的計算機,用來訓練AI模型。
第二類,用來讓AI學習技能。
你不能只是把AI編寫出來,就讓它進入物理世界隨意嘗試。學習應該先在數字孿生中進行。
我們創建了Omniverse數字孿生平台。
剛才看到的很多CUDA-X演示,都運行在數字孿生世界中。
Omniverse是一組可以接入各種平台和工具的庫,包括西門子、達索系統、Cadence等公司的平台。它們共同構建數字孿生系統。
第三類,是部署在機器人上的計算機。
對於自動駕駛汽車和自動駕駛出租車,我們將相關平台稱爲Hyperion。
它包括計算機本身、功能安全系統、主動安全系統,以及專爲物理AI安全設計的操作系統。
我們也需要爲機器人提供同樣完整的平台。
這樣,當大家開始研究或開發機器人時,就不必從零拼裝所有軟件、計算系統、傳感器和機械部件。僅僅完成這些準備工作,就可能耗費幾年時間。
因此,我們決定打造一款參考機器人。
這就是英偉達與Agile Robots合作的Agile One。
這款參考機器人預計將在明年第一季度提供,出廠時已經完成組裝,內置計算機,集成軟件,開箱即可具備相當不錯的能力。
它將成爲一個很好的起點,推動機器人開發加速。
現在,讓我們回到演講開始的地方。
英偉達誕生於個人電腦革命之中。
1993年,我們成立時,PC革命正準備進入新的階段;Windows 95隨後讓它進一步加速。
此後,我們發明了GPU,推動可編程着色和實時光線追蹤發展,將CUDA加入計算模型,並幫助點燃現代AI革命。
四年前,我們開始思考:面對新的時代,能否重新定義個人電腦?
它不再只是你的工具,而是你的個人智能體、個人助手。你與它的互動,更像與一位幫助你工作的夥伴交流。
因此,這台計算機需要具備今天介紹的五個部分。
它需要模型,模型可以在本地運行,也可以在雲端運行。
它需要智能體框架。
它需要OpenShell安全運行時。
它還需要訪問個人電腦中的知識和工具。
好消息是,英偉達已經加速這些工具很多年。
只要我們創造一臺同時支持OpenGL、DirectX和CUDA加速的計算機,英偉達過去開發的一切就都能夠在其上運行。
這就是成果。
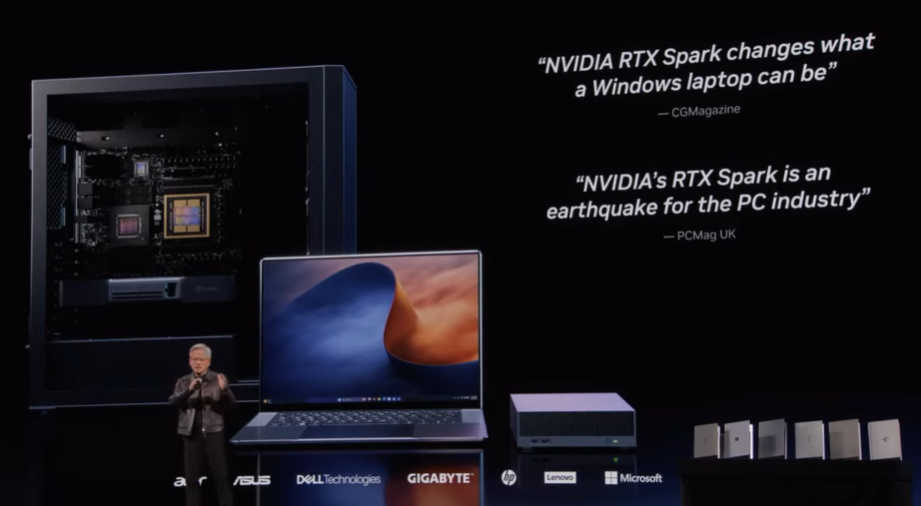
經過四年與微軟的合作,我們打造了RTX Spark,這是一條全新的計算機產品線。
數千個工程人年的投入,凝結在其中。我們祕密研發了四年,創造了一顆名爲N1X的芯片,最近與整個PC產業共同發佈。
我們打造了臺式機、筆記本電腦和工作站。
這台設備提供1 PFLOPS算力。
作個對比:2016年,我向當時還很小的OpenAI交付了一臺擁有1 PFLOPS算力和128GB內存的計算機。
現在,這台小設備同樣提供1 PFLOPS算力和128GB內存。
區別在於,我可以這樣把它拿在手裏,而當年的DGX-1需要兩個人才能抬上樓。
這就是全新的RTX Spark PC。
如果你想要一臺運行CATIA、達索系統其他軟件,以及Autodesk、Adobe、Cadence和Synopsys工具的配套工作站,也可以選擇運行Windows的DGX Station。
它提供20 PFLOPS算力和754GB內存。
此外,還有桌面版本。
相關產品正在推出,運行Windows的DGX Station預計將在今年年底上市。
現在,我已經講了智能體的五個組成部分。接下來的問題是,怎麼構建智能體?
如何讓它運行在這些計算機上,或者運行在雲端、企業本地環境中?
答案其實很簡單。
構建智能體的方法,就是請一個智能體替你構建。
接下來,這段提示詞將驅動一個應用。
大家將看到一個機器人應用演示。觀看時請記住,這台個人電腦上運行着一個智能體,而整套演示涉及三類計算機:
第一類用於訓練。
第二類運行數字孿生。
第三類將AI部署到機器人本身。
這裏有兩個核心概念:一是如何構建和運行智能體,以及能用它做什麼;二是由三類計算機構成的物理AI計算模式。
我們來看演示。
視頻旁白:
這是Hugging Face的機器人Micro Duck。
讓我們使用NVIDIA RTX Spark,教它觀察世界和行走。
我使用Hermes作爲智能體框架,以Nemotron和OpenAI的GPT-6 Astra作爲模型,並使用CUDA-X加速工具:FreeCAD、Blender、Isaac Sim、Newton物理引擎和Isaac Lab。
除非需要將大型工作負載擴展到雲端,否則所有任務都在RTX Spark上運行。
首先,我描述訓練場地,以及Micro Duck需要學會什麼。
RTX Spark上的Hermes和Nemotron規劃場地,列出所需的全部物體。
隨後,Astra使用FreeCAD建立三維物體模型,用Blender賦予材質,再通過Omniverse仿真就緒庫添加物理屬性。
Astra在Isaac Sim中佈置場景,爲Micro Duck配置關節、執行器和連接結構,再利用Newton物理引擎模擬它的運動。
接下來開始訓練。
雲端的Isaac Lab讓數千個Micro Duck同時訓練。
每一次跌倒都是一次學習機會,推動控制策略不斷改進。
Omniverse庫模擬Micro Duck的攝像頭,教它「看見」環境。
當感知與物理能力結合後,Micro Duck能夠避開障礙、穿過狹窄空間,並適應周圍環境。
我將訓練策略下載到RTX Spark,使用Nemotron和Isaac Sim,通過多智能體編排對Micro Duck進行評估。
最後,將通過驗證的策略部署到真實機器人上,它就可以開始行動了。
NVIDIA RTX Spark,讓你直接在筆記本電腦上構建和運行AI智能體及其加速工具。
黃仁勳:
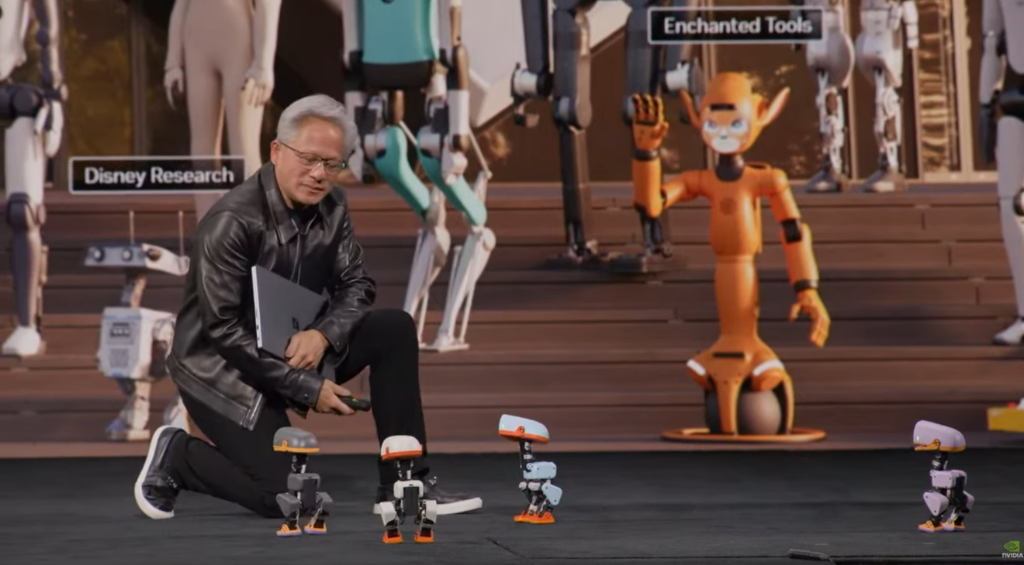
你們好!過來,給大家看看你們會走路。
你們還有攝像頭。小心,別絆倒。
能坐下嗎?現在站起來。休息一下,再站起來。
你們知道自己是在這裏被創造出來的嗎?
你們誕生於RTX Spark,在雲端的大量英偉達超級計算機上接受訓練,並在RTX Spark上的Omniverse數字孿生中學習技能。
是不是很神奇?
你們真可愛。你們的「父母」叫Pollen,對吧?Pollen Robotics。
聽說大家太喜歡你們了,已經賣光了。
所有觀看這段視頻的朋友——可能會有兩千萬人——都可以去Pollen的網站看看,下一筆訂單。
這家初創公司大概只有十個人,訂單可能一下子就把他們淹沒了。
每個人都應該有一隻,你們太可愛了。
有一臺RTX Spark,我們就能繼續教你們新技能。
能翻個跟頭嗎?
太棒了!
那麼,今天我們談了什麼?
我們談到了歐洲建設自己的AI經濟,而這一切從基礎設施開始。
我們發佈了新的DSX Pod系統,讓建設AI工廠更加容易。
而這些AI工廠,不再只是運行模型。
[轉向機器人。]
集中注意力,過來,坐下。
這些工廠運行的是完整的智能體。
智能體包含五個部分:
大語言模型負責感知、推理、規劃和行動。
智能體框架相當於它的外骨骼,負責協調運行。
框架運行在OpenShell安全運行時中。
再賦予它訪問知識和工具的能力。
這些智能體運行在我們的計算機上,而我們還在向下一代擴展,也就是物理AI。這就是你們這些小機器人的用武之地。
每個人都能構建智能體,歐洲每家公司都會成爲AI公司,這一點毫無疑問。
歐洲將擁有蓬勃發展的AI經濟。
33年來,這是一段不可思議的旅程。我們製作了一段很酷的視頻,你們要一起看嗎?
過來一點,我們讓開舞臺。全速前進!
視頻主持人:
這樣的演示之後,我們還能拿什麼接着上場?
有一件事,能讓現場更沸騰。
是什麼?
你絕對想不到,GTC要變成歐洲歌唱大賽了!
黃仁勳:
感謝大家,感謝所有贊助商,也感謝33年來與我們一路合作的夥伴。
還有Micro Duck,我的新朋友們。
讓我們一起建設歐洲的AI經濟,讓AI真正投入工作。
祝大家度過一場精彩的GTC!