
Gemini 3.8 Live支持97種語言,用戶無需等任務完成後再繼續對話,該模型可邊繼續交流邊讓任務在後台運行,且支持實時視覺上下文,用戶可通過聲音提問,還可讓模型理解正看到的內容。Gemini 3.8 Live Extended Thinking讓AI「邊說邊想」,複雜任務也不必打斷對話,在Artificial Analysis獨立測評中得分第一。谷歌稱其AI產品生成的音頻「可檢測」、均會加入SynthID不可見水印。
谷歌把旗下Gemini模型的戰場從文字和代碼推進到了實時語音。
當地時間9月15日,谷歌宣佈推出Gemini 3.8 Live和Gemini 3.8 Live Extended Thinking兩款實時音頻模型,並稱這是其目前最先進的實時對話模型。兩款模型不僅可以進行更加自然、流暢的語音交流,還能在對話不中斷的情況下調用工具、處理視覺信息和執行復雜任務。
 其中,Gemini 3.8 Live主打大規模、低成本的自然語音應用,支持實時視覺理解和多語言對話;Gemini 3.8 Live Extended Thinking則進一步加入深度推理能力,可以一邊「思考」一邊說話,在用戶繼續交流的同時於後台完成多步驟任務。谷歌表示,後者在Artificial Analysis的Speech to Speech Quality Index中排名第一,得分82.6。
這意味着,谷歌正在嘗試讓實時語音AI從此前的「語音版聊天機器人」,進一步變成能夠聽懂、思考、調用工具並把事情做完的語音智能體(Agent)。
從「語音聊天」到「邊聊邊辦事」,實時音頻能力大升級
Gemini 3.8 Live的核心變化,是讓語音交互不再只是「你說一句、AI回答一句」。
谷歌表示,新模型可以在保持連續對話的同時,在後台異步執行工具和API調用。用戶無需等待任務完成後再繼續說話,模型可以一邊繼續交流,一邊讓相關任務在後台運行。
例如,在多步驟任務中,模型可以先回應用戶,再在後台調用相關工具;任務完成後,再將結果融入當前對話。
這種能力尤其適合語音智能體。傳統語音應用往往需要把語音識別、語言模型和語音合成多個環節串聯起來,任何一個環節的延遲都會影響用戶體驗。谷歌此次則強調,Gemini 3.8 Live屬於原生的speech-to-speech模型,可以直接圍繞實時語音交互完成推理和任務執行。谷歌開發者博客稱,這種架構能夠減少傳統「級聯式」語音系統的複雜性。
與此同時,新模型支持實時視覺上下文。用戶不僅可以通過聲音提問,還可以讓模型理解正在看到的內容,從而實現更具上下文的語音交互。谷歌展示的場景包括實時員工培訓、故障排查以及讓AI通過視覺信息參與棋局等。
97種語言無縫切換,瞄準全球化語音應用
多語言能力也是Gemini 3.8 Live的一大賣點。
谷歌表示,3.8 Live支持97種語言,並能夠在對話過程中自動識別並切換語言,同時保持一致的語音表現。
谷歌AI Studio軟件主管Logan Kilpatrick也表示,新模型支持97種語言,並加入異步工具調用等能力。
對於企業而言,這意味着開發者可以用一套模型構建覆蓋不同市場的語音智能體,而無需針對不同語言分別設計複雜的語音處理系統。
谷歌開發者博客還特別強調了新模型對字母數字信息的處理能力,包括確認碼、索賠編號和技術數據等。這類信息對於客服、金融、醫療和企業服務等語音場景尤其重要,因爲傳統語音系統往往容易在數字、字母和專業術語識別上出現錯誤。
價格方面,谷歌將Gemini 3.8 Live和3.8 Live Extended Thinking定位爲具有競爭力的前沿模型。開發者通過Live API調用時,音頻輸入價格爲每分鐘0.005美元,音頻輸出爲每分鐘0.018美元。
Extended Thinking讓AI「邊說邊想」,複雜任務也不必打斷對話
如果說3.8 Live解決的是「如何讓AI更自然地說話」,那麼3.8 Live Extended Thinking解決的則是「如何讓AI在說話的同時完成複雜工作」。
谷歌稱,Extended Thinking可以在保持實時對話的情況下進行更深層次的推理。模型甚至可以通過「讓我查一下……」之類的語音提示,讓用戶知道它已經開始處理任務,而不是陷入長時間的無聲等待。
更重要的是,模型能夠在後台執行多步驟任務,同時維持前臺對話。
谷歌展示的案例包括:通過異步函數調用完成多步驟預訂、根據用戶的語音和草圖實時生成React組件,以及直接通過自然語言完成商業計劃和營銷工具包的製作。
這實際上進一步強化了谷歌此前不斷強調的Agentic路線——AI的價值不再只是給出答案,而是能夠在理解用戶意圖之後,調用工具、處理信息並最終完成任務。
獨立評測排名第一,3.8 Live瞄準生產級語音智能體
谷歌此次也拿出了第三方評測成績爲新模型背書。
根據谷歌披露的數據,Gemini 3.8 Live Extended Thinking在Artificial Analysis的Speech to Speech Quality Index中排名第一,得分82.6;在τ-Voice智能體任務測試中,完成率達到68.6%,在Sierra的τ-Voice-banking測試中達到35.1%;在Big Bench Audio測試中得分97.7%。
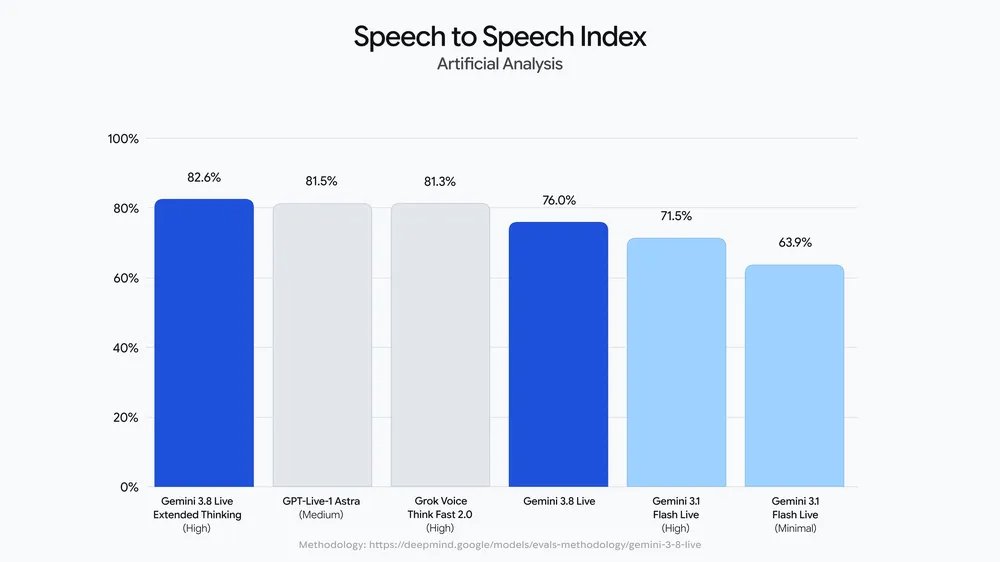
普通版Gemini 3.8 Live則在Speech Agent Arena中排名第二,同時強調成本效率和規模化部署能力。谷歌表示,這款模型尤其適合開發者和企業構建生產級語音智能體。
谷歌並沒有將兩款模型簡單定位爲消費者聊天產品,而是同時瞄準開發者和企業市場。
目前,兩款模型均已經通過Gemini API和谷歌AI Studio向開發者開放;企業用戶可以在Gemini Enterprise中參與私有預覽。普通用戶則可以通過Search Live和Gemini Live使用相關能力。
與此同時,Gemini 3.8 Live Extended Thinking還被引入Google Workspace,可用於Docs、Gmail和Keep等產品。
AI語音全面落地,但谷歌也強調「可檢測」
隨着生成式AI開始越來越多地進入語音通話、客服、搜索和辦公場景,AI生成聲音的透明度也成爲谷歌此次發佈中特別強調的一環。
谷歌表示,其所有AI產品生成的音頻均會加入SynthID不可見水印。這一水印直接嵌入音頻輸出,幫助識別AI生成內容,並降低生成式AI被用於傳播虛假信息的風險。
這也意味着,谷歌在推動語音AI進入更廣泛生產環境的同時,試圖同步解決「用戶是否知道自己正在與AI交互、這段聲音是否由AI生成」等問題。
從搜索到Workspace,再到開發者API和企業智能體平台,Gemini 3.8 Live的覆蓋範圍已經明顯超越單純的語音助手。
對於谷歌而言,這一輪升級的意義或許並不只是推出兩款新的音頻模型,而是進一步完善Gemini從文本、圖像、視頻、代碼到實時語音的多模態能力,並將語音直接連接到工具調用和智能體執行。
換句話說,谷歌正在押注的下一階段AI交互方式,可能不再是「打開一個聊天窗口提問」,而是像與真人同事交流一樣說話,同時讓AI在後台把事情做完。
編輯/stephen